У меня четыре VPS и около двадцати пяти «проектов»: продукты с живыми пользователями, пет-проекты и инфраструктура — MySQL, ClickHouse, бэкапы, Telegram Bot API, реле в AWS. За всем этим следит один Netdata-парент: дети стримят ему метрики, он считает алерты и шлёт их в Telegram, критичное — ещё и в Pushover. Про эту часть я уже писал.
Не было одного: ответа на вопрос «у меня сейчас всё хорошо?» одним взглядом. Алерт в Telegram — событие, через час оно тонет среди других сообщений. Дашборд Netdata — сотни чартов на каждой ноде; чтобы понять, жив ли бот, надо помнить, где он живёт и как называется его чарт. А ещё хотелось публичную страницу «всё работает» на сайт — так, чтобы снаружи никто не увидел внутренностей.
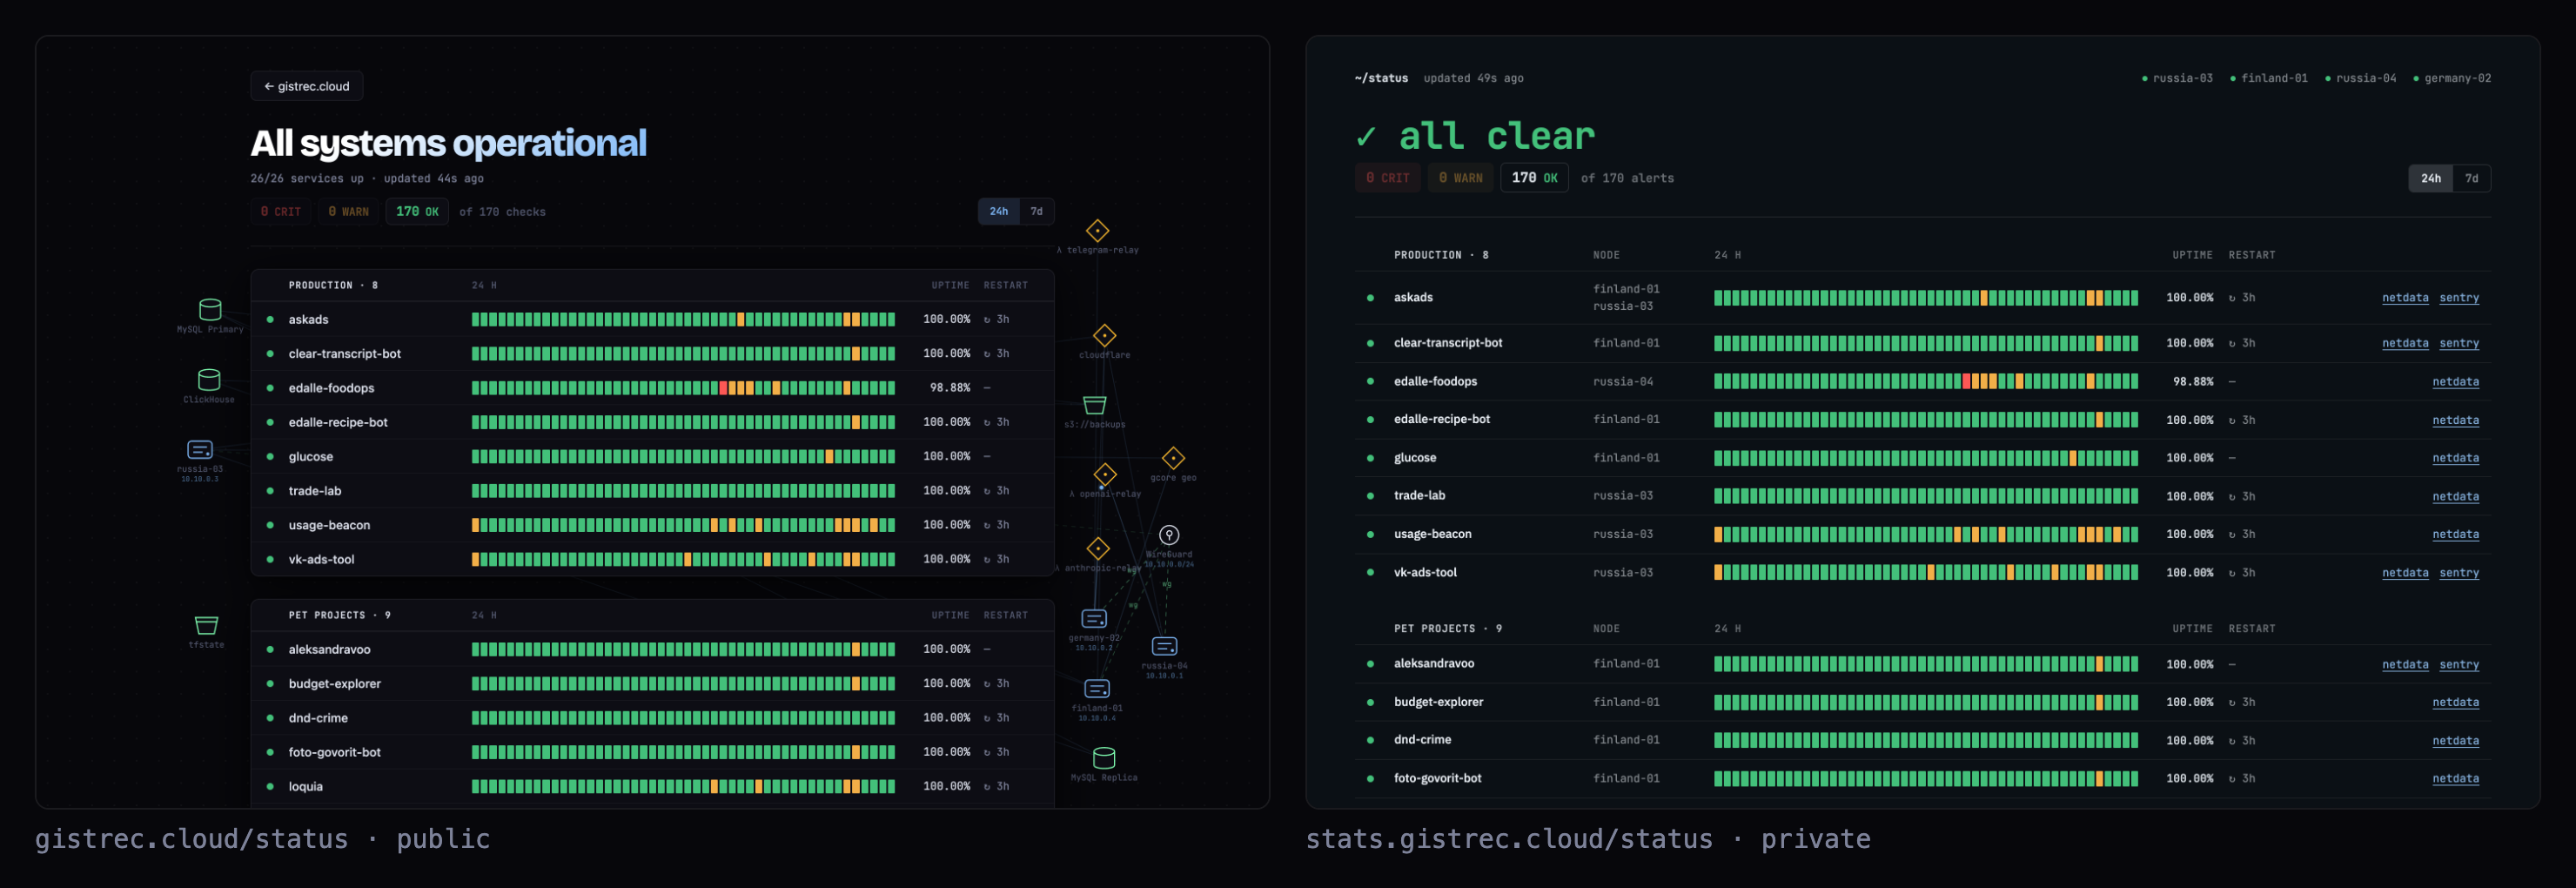
Получилось две страницы на одном снимке данных: приватная stats.gistrec.cloud/status с алертами, нодами и ссылками и публичная gistrec.cloud/status — только имена, точки и полоски истории. Под ними 372 строки Python, которые раз в минуту ходят в API парента, и systemd-таймер. Ни Netdata Cloud, ни Grafana, ни Prometheus.
Что уже было
Вся проверка живости у меня — это джобы go.d и шаблоны алертов в health.d на паренте:
httpcheckна/healthприложений (глубокие проверки: приложение само ходит в MySQL/ClickHouse и отдаёт 503, если база не ответила);portcheckтам, где за портом не HTTP;pingдо соседних нод, до finland-01 — по двум путям, через WireGuard и по публичному адресу;filecheckна маркеры.last-success, которые трогают скрипты бэкапов и S3-зеркала;x509checkна сертификаты прямо на диске;mysqlиclickhouseколлекторы;- группы pm2-процессов в
apps.plugin— один шаблонpm2_app_downна все группы с префиксомpm2_.
Правило одно: шаблоны алертов живут только на паренте. Он считает их и по чартам детей, которые к нему стримятся, так что одна копия правила покрывает весь парк. Поставить тот же файл на ребёнка — получить два уведомления на одно событие.
Типичный файл — на пару десятков строк:
# health.d/tg-bot-api.conf
# Telegram Bot API на finland-01: общий (tg_bot_api_shared, клиенты — RF-боты по
# туннелю) и приватный ctb (tg_bot_api_ctb). Корень отдаёт 404 — это и есть «жив».
    template: tg_bot_api_down
          on: httpcheck.status
chart labels: _collect_job=tg_bot_api_*
       class: Errors
        type: Web Server
   component: Telegram Bot API
      lookup: average -2m unaligned of success
       units: ok
       every: 10s
        crit: $this < 0.5
       delay: down 2m multiplier 1.5 max 1h
          to: sysadmin
        info: Telegram Bot API ${label:url} не отвечает на половину проб за 2 минуты — боты не получают и не шлют сообщения
В Netdata уже лежало всё, что нужно статус-странице: и текущее состояние, и история проб. Не хватало только представления.
Попытка номер один: обойтись дашбордом агента
Первая мысль — не писать ничего. В Netdata 2.x есть встроенный дашборд, у него есть «кастомные дашборды». Без входа в Netdata Cloud они ограничены. По документации (обновлена 19 октября 2026) анонимному пользователю положен один кастомный дашборд на агент, а на локальном дашборде агента и парента действует лимит в пять нод. У меня нод четыре, так что запас — одна.
Но дело даже не в лимитах. Мне нужна была таблица: проект → состояние → история за сутки и неделю → где живёт → ссылки. Дашборд агента оперирует чартами и нодами. Понятия «проект» в Netdata нет вообще, его нужно было откуда-то вывести.
Так что требования к своей странице сложились сами:
- Не заводить вторую систему проб. Источник истины — алерты парента, страница показывает ровно то, что видит алертинг, и ничего сверх.
- Публичная версия не раскрывает ничего, кроме имён проектов и их состояния.
- Никаких новых сервисов: Python из stdlib, статический HTML, nginx, который уже стоит.
Откуда берётся «проект»
Парент знает своих детей: GET /api/v1/info возвращает mirrored_hosts. Для каждого хоста алерты лежат за своим префиксом — /host/<имя>/api/v1/alarms, для самого парента префикс пустой.
Первые грабли: GET /api/v1/alarms без параметров не отдаёт алерты в состоянии CLEAR. Чтобы получить все, нужно ?all. Без него скрипт радостно сообщает, что алертов нет, — и это ложь.
Дальше — как сгруппировать две сотни алертов по проектам. У каждого алерта в ответе есть поле source с путём до файла, из которого он загружен. А у меня и так один файл в health.d на проект. Значит, проект — это имя файла:
def project_of(a):
    for rx, row in EXTERNAL_CHARTS + INFRA_CHARTS:
        if re.search(rx, a['chart']):
            return row
    m = re.search(r'file=/etc/netdata/health\.d/([^,]+)\.conf', a.get('source') or '')
    if not m:
        return None
    key = m.group(1).lower().replace('_', '-')
    for rx, row in INFRA_FILES:
        if re.search(rx, key):
            return row
    if a['name'].startswith('host_clock_'):
        return 'VPS'
    if key in ('pm2', 'pm2-memory'):
        c = re.match(r'^app\.pm2_(.+)_(processes|mem_usage)$', a['chart'])
        if not c:
            return None
        key = c.group(1).lower().replace('_', '-')
    return ALIASES.get(key, key)
Первой проверяется группа, которой поначалу не было: внешние API, от которых зависит askads (Yandex Direct, Metrica, Wordstat, Webmaster, VK Ads). Их пробы askads делает сам, без токена, поэтому series умеет брать сразу два измерения чарта (success,no_connection): если не ответил сам askads, отрезок считается «нет данных», а не сбоем чужого API. Сбой такого API не наш, поэтому заголовок страницы из-за него становится максимум жёлтым.
Исключения в этой функции и есть вся «бизнес-логика»:
- pm2-алерты приходят из одного файла
pm2.confна все приложения, поэтому имя проекта берётся из имени чартаapp.pm2_<app>_processes; - инфраструктурные файлы (
mysql,clickhouse-down,s3-mirror,tg-bot-api,lambda-relay,fleet-*) сворачиваются в строки «MySQL», «ClickHouse», «S3 Backups», «Network», «VPS» — таблицей регулярок; - чарты
x509check_*иportcheck_k3s_*идут в строки «TLS» и «k3s» независимо от файла; - алерты из стоковых файлов Netdata (
project_ofвернулаNone) попадают на страницу только когда горят, в строку «VPS». Иначе страница утонет в десятках зелёных системных алертов с каждой ноды.
Ключи с суффиксом — askads-cloud, trade-lab-clock, dnd-crime-api-staging — merge_prefixes() сворачивает к самому короткому существующему префиксу: это части проектов askads, trade-lab, dnd-crime. А алерты нод, которые я снёс, остаются на паренте с застывшим last_updated — такие отбрасываются, если им больше часа (STALE_SEC = 3600).
Тип строки — infra, prod или pet — берётся из списка netdata_projects_prod в host_vars. От типа зависит вердикт в шапке: WARNING пет-проекта и стоковые WARNING считаются в плашках, но не портят заголовок «all clear». На момент написания так и есть: в снимке 3 WARNING, вердикт зелёный.
История без alarm_log
Я рассчитывал, что историю состояний отдаст GET /api/v1/alarm_log — там переходы алертов. 23 октября на паренте с Netdata 2.11 он вернул пустой ответ, ноль байт. В тот же день я обновил парент до 2.12.1, и журнал заработал, но для страницы это ничего не меняет. 28 октября он отдал ровно 1000 записей, и самая старая была 38 часов назад: журнал хранит последнюю тысячу переходов, на окно в неделю её не хватает. В 2.12.1 есть и /api/v2/alert_transitions (за сутки на паренте: 141 WARNING, 141 CLEAR, 2 CRITICAL), но это те же переходы статусов. Из них не посчитать главное — какая доля проверок в отрезке прошла.
История у Netdata всё равно есть, просто не в журнале алертов, а в самих чартах проб. Каждая проба — чарт с историей, и GET /api/v1/data умеет отдавать её сразу агрегированной:
RANGES = {'24h': (86400, 48), '7d': (604800, 42)}

def series(parent, host, chart, dim, group, rng):
    after, points = RANGES[rng]
    q = urllib.parse.urlencode(dict(chart=chart, after=-after, points=points, group=group,
                                    format='json', dimensions=dim))
    d = get(f'{base(host, parent)}/api/v1/data?{q}')
    rows = list(reversed(d['data']))
    if ',' in dim:  # несколько измерений — отрезок как {измерение: значение}
        vals = [None if all(x is None for x in r[1:]) else dict(zip(d['labels'][1:], r[1:])) for r in rows]
    else:
        vals = [r[1] for r in rows]
    v = ([None] * max(0, points - len(rows)) + vals)[-points:]
    return v, [r[0] for r in rows]
За сутки — 48 отрезков по 30 минут, за неделю — 42 отрезка по 4 часа. Агрегацию (average, max, min) делает сама Netdata, скрипту остаётся привести значения к одной шкале: 1 — норма, около 0.96 — warning, 0 — critical. Для каждого типа пробы свой чарт и своя нормализация:
| Проба | Чарт | Измерение, агрегация | Что значит 1 |
|---|---|---|---|
| httpcheck / portcheck | httpcheck_<job>.request_status, portcheck_<job>_status | success, average | все пробы отрезка успешны |
| ping | ping_<job>.host_packet_loss_* | loss, average → 1 - loss/100 | нет потерь |
| mysql / clickhouse | mysql_<job>.queries, clickhouse_<job>.uptime | любое значение → 1, пропуск после первой точки → 0 | коллектор собрал данные |
| filecheck | filecheck_<job>.file_modification_time_ago | mtime_ago, max → по порогам алерта | маркер свежее warn-порога |
| x509check | x509check_<job>.cert_depth0_time_until_expiration | expiry, min → 1 / 0.96 / 0 | до истечения больше 14 дней |
| pm2 (если проб нет) | app.pm2_<app>_processes | processes, min → > 0 | процесс был жив весь отрезок |
Для баз логика особая: у mysql_down и clickhouse_down алерт — это «возраст последнего сбора больше минуты» ($now - $last_collected_t). Поэтому в истории дырка в данных после первой точки означает «сервер не отвечал», а не «данных нет» — флаг gap_down. Пороги у filecheck те же, что в алертах: 30/50 часов для суточных бэкапов, 13/25 для S3-зеркала, которое ходит раз в 6 часов.
Проб у проекта может быть несколько (у loquia — три /health, по одному на процесс). На отрезок берётся худшая:
merged, bad = [], []
for i in range(points):
    vals = sorted((r[i], k) for k, r in enumerate(rows) if r[i] is not None)
    merged.append(vals[0][0] if vals else None)  # худшая из проб в отрезке
    # все пробы ниже нормы, худшая первой: [индекс в labels, значение]
    bad.append([[k, round(x, 4)] for x, k in vals if x < OK_FROM] or None)
# жёлтый отрезок — деградация, не простой: в uptime идёт как полный
known = [1 if x >= WARN_FROM else x for x in merged if x is not None]
return dict(v=[None if x is None else round(x, 4) for x in merged], t=t, w=bad, labels=labels,
            uptime=round(sum(known) / len(known) * 100, 2) if known else None)
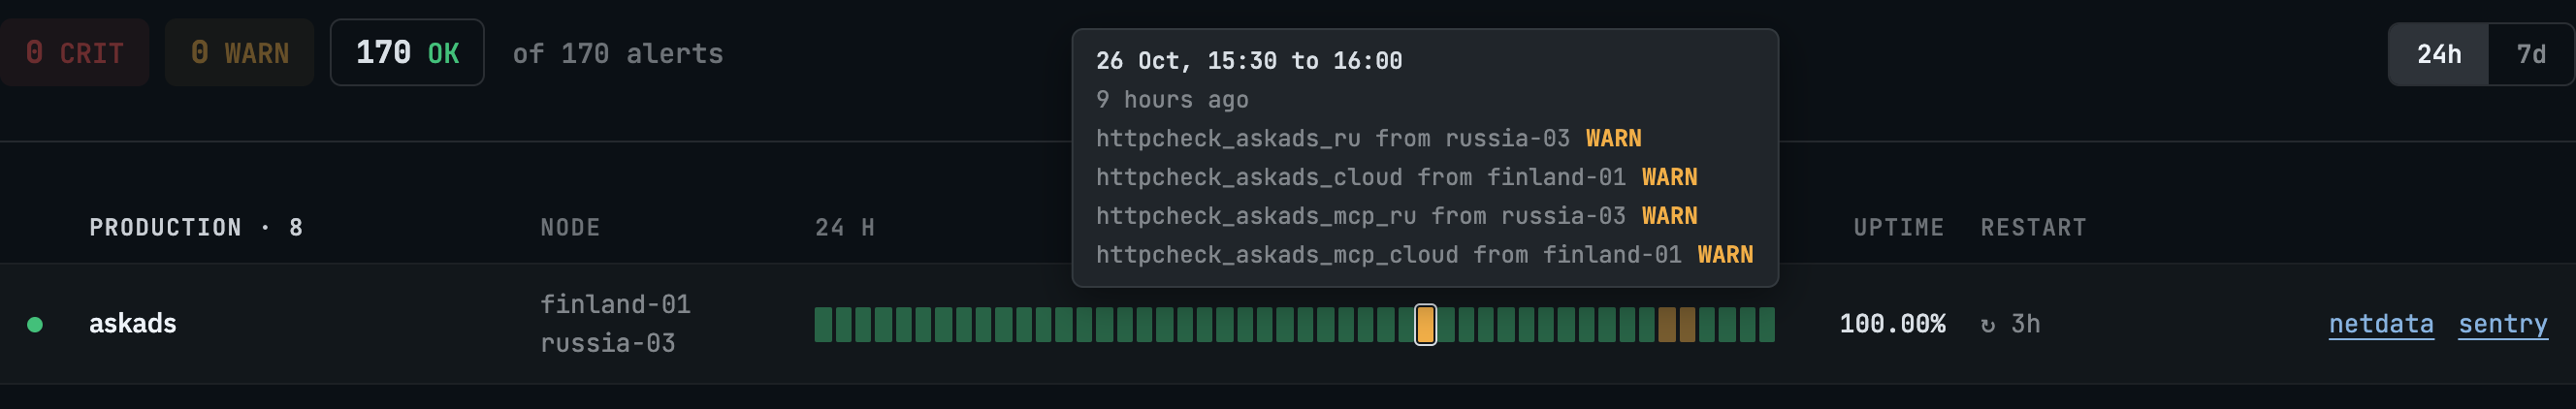
Страница красит клетку: >= 0.999 (OK_FROM) зелёная, >= 0.95 (WARN_FROM) жёлтая, ниже — красная, None — серая. Кроме худшего значения, для каждого отрезка сохраняется список всех проб ниже нормы — его показывает подсказка над клеткой. «Аптайм» справа от полоски — среднее по известным клеткам, причём жёлтая клетка считается полной: короткий сбой одной пробы — это деградация, а не простой. Это не аптайм в смысле SLA, и пороги 0.999/0.95 я выбрал на глаз.
Отдельный сюрприз — свежие чарты. Когда я добавлял новую пробу, на окнах 24h и 7d она отдавала «no data»: агрегированные тиры хранилища ещё пустые, данные накапливаются. Пустой ответ превращается в ряд None — серые клетки. А если чарта ещё нет совсем, запрос падает с ошибкой; поэтому каждая проба обёрнута в try/except и при ошибке просто пропускается — одна проба без чарта не должна валить всю строку.
Так это выглядело 23 октября на чарте mysql_local.queries, через несколько минут после включения коллектора. Окно в сутки — пусто, последние десять минут — данные есть:
GET /api/v1/data?chart=mysql_local.queries&after=-86400&points=48&group=average&dimensions=queries&format=json
{"labels":["time","nodata"],"data":[]}

GET /api/v1/data?chart=mysql_local.queries&after=-600&points=3&dimensions=queries&format=json
{"labels":["time","queries"],"data":[[1792753800,46.5084614],[1792753600,null],[1792753400,null]]}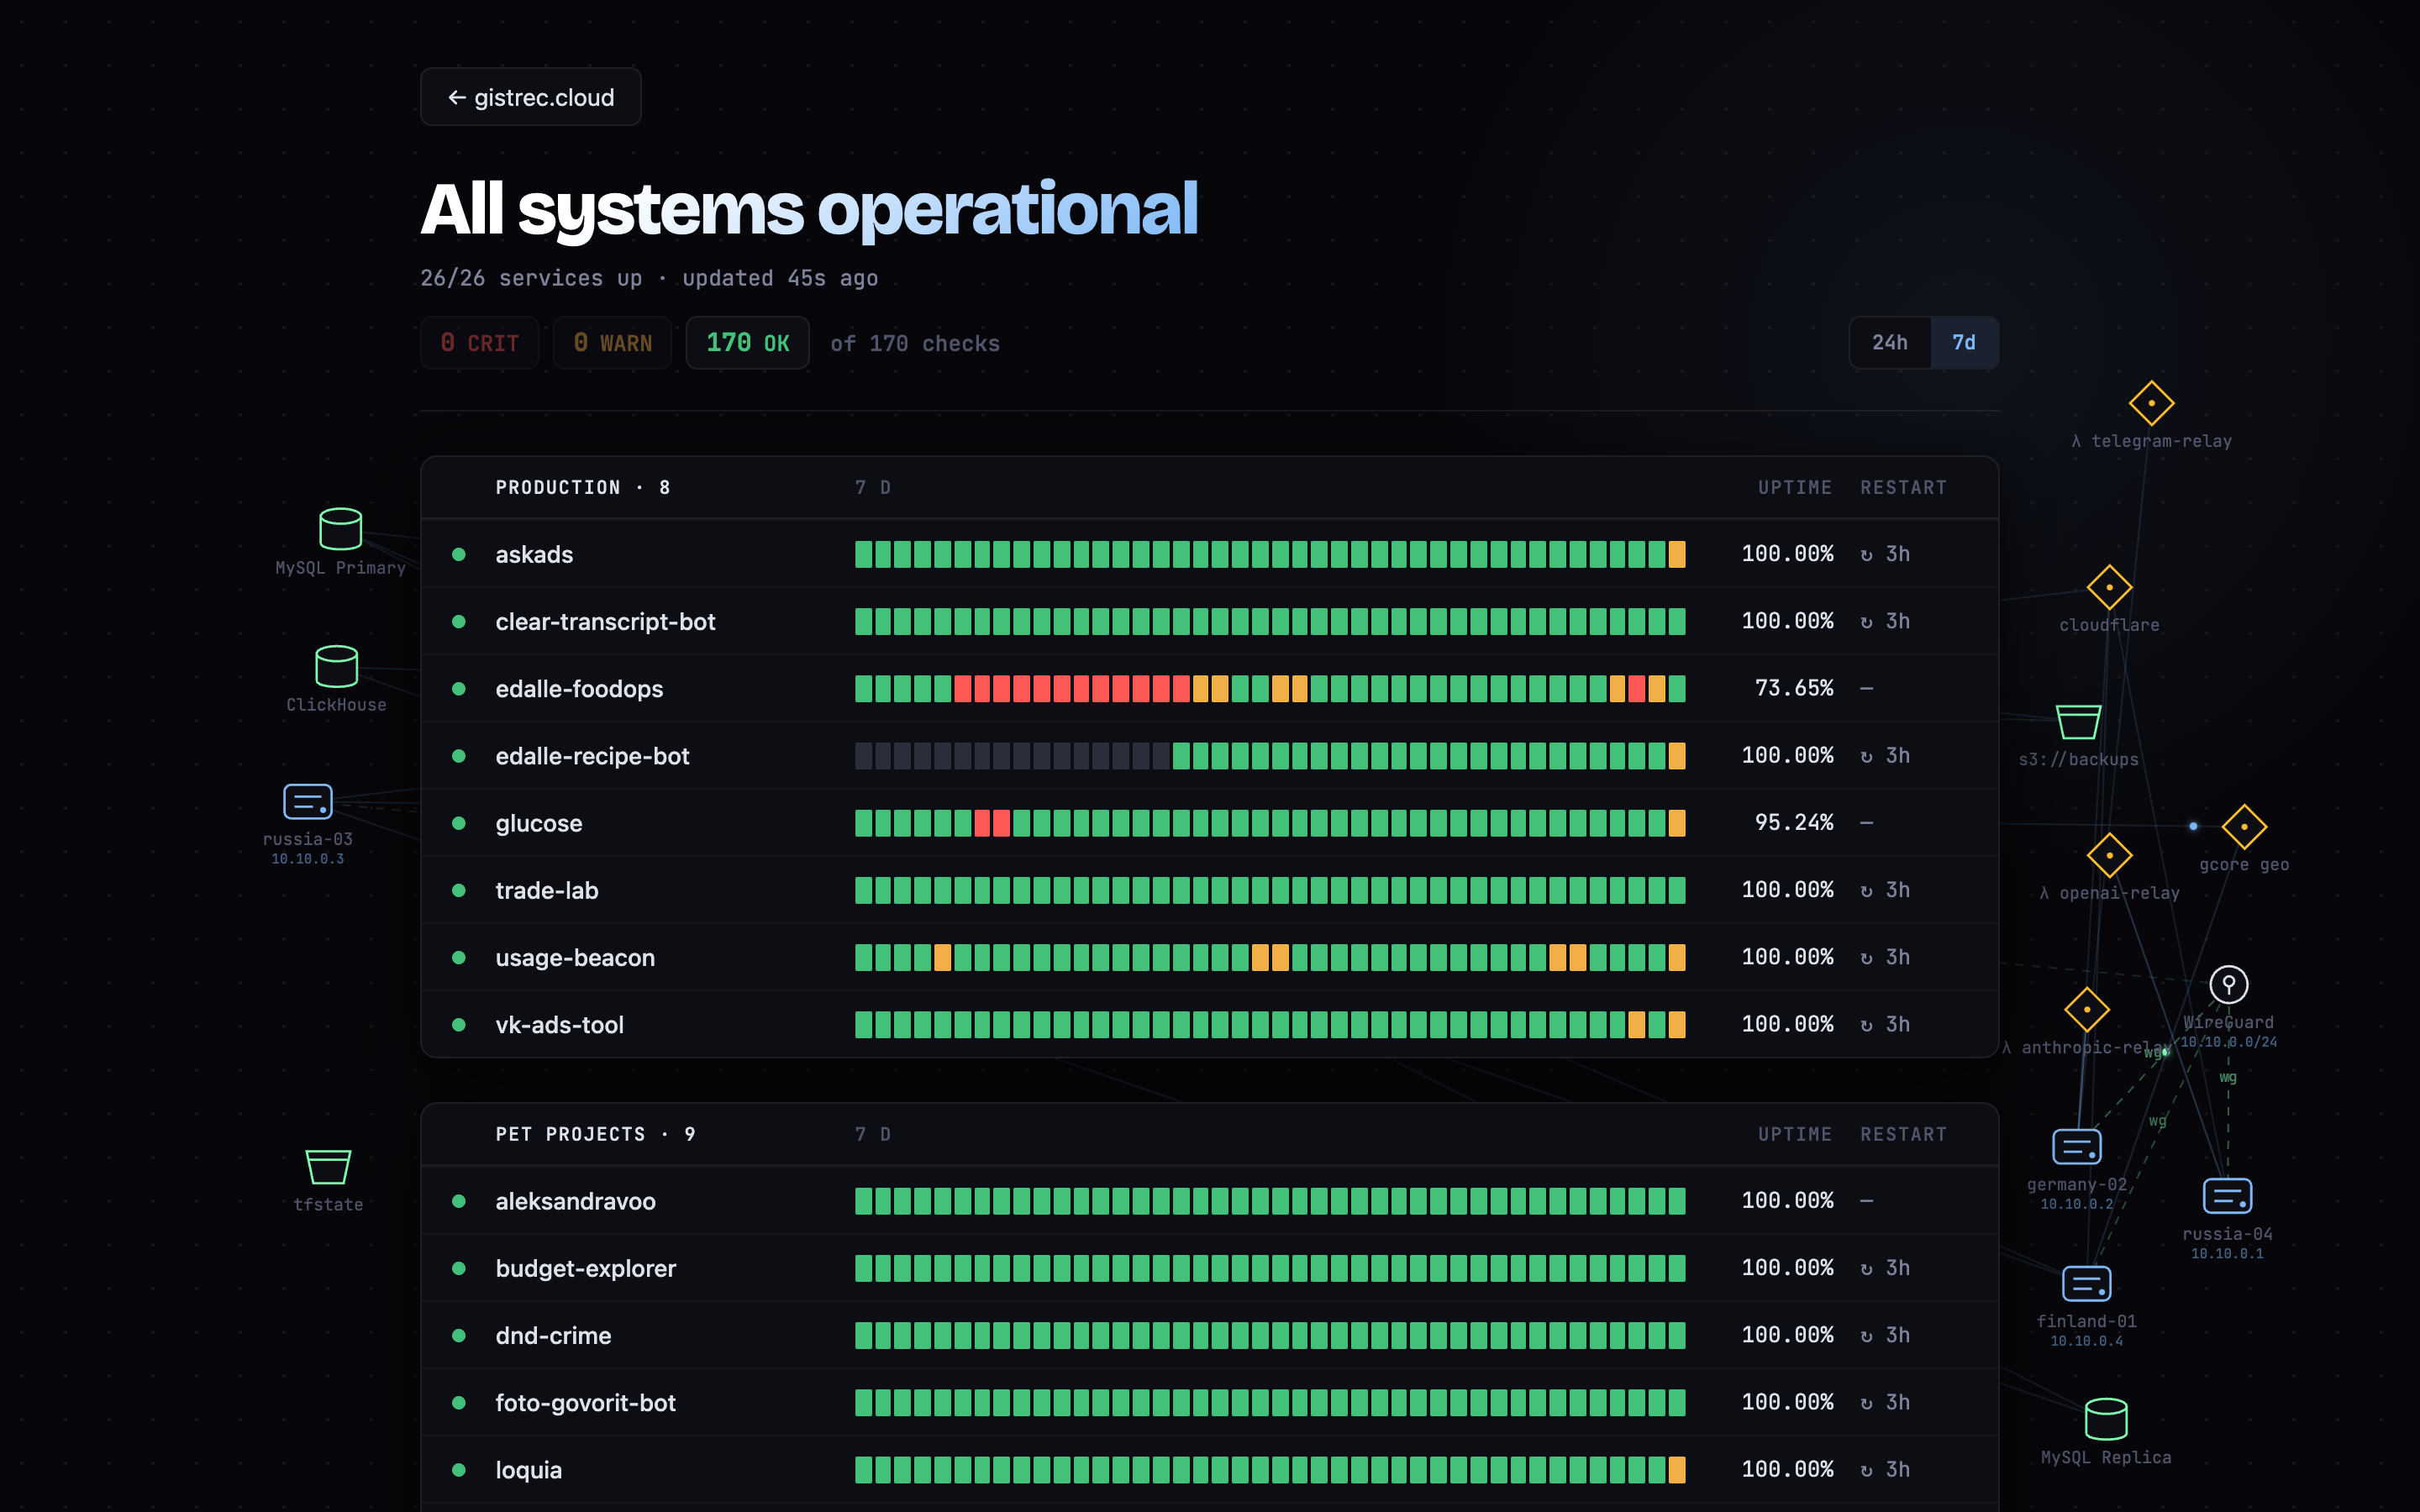
Семантика времени: метка — это конец отрезка
В ответе /api/v1/data у каждой точки есть метка времени, и это конец уже закрытого отрезка, а не начало и не середина. Понял я это не из документации, а по странице. Последняя клетка полоски описывает последние закрытые 30 минут, «текущего интервала» в ней нет.
На странице это выглядело так: точка проекта жёлтая (алерт горит), а вся полоска зелёная — потому что горит он три минуты, а отрезок закрылся до этого. Выглядит как баг.
Решение — поднимать последнюю клетку до цвета текущего алерта и писать в тултипе «firing now»:
// текущий отрезок не светлее текущих алертов строки: иначе точка жёлтая, а полоса зелёная
const NOW_CLS = { warn: 1, crit: 2, outage: 3 };
function histCell(p, dot) {
  const h = p.history[state.range];
  const n = RANGES[state.range].points;
  if (!h) return { bars: '<i></i>'.repeat(n), uptime: '—' };
  const cls = h.v.map(bucketCls);
  const lifted = (NOW_CLS[dot] || 0) > (NOW_CLS[cls[n - 1]] || 0);
  if (lifted) cls[n - 1] = dot;
  ...
}
В тултипе границы отрезка считаются от метки назад: end - step … end. Если метка в будущем (отрезок ещё идёт), подпись — «current interval»; если клетка поднята — «firing now»; иначе — сколько прошло, словами («9 hours ago»). Ниже идут пробы, которые в этом отрезке были ниже нормы, со статусом каждой.
Рестарты: pm2-аптайм вместо времени деплоя
В таблице хотелось колонку «когда последний раз деплоил». Netdata про деплои ничего не знает. Зато apps.plugin на каждую pm2-группу отдаёт чарт app.pm2_<app>_uptime. Беру последнее значение по каждой группе проекта и минимум из них:
def restart(parent, alarms):
    ups = []
    for a in alarms:
        if m := re.match(r'^app\.pm2_(.+)_processes$', a['chart']):
            try:
                d = get(f"{base(a['host'], parent)}/api/v1/data?chart=app.pm2_{urllib.parse.quote(m[1])}_uptime"
                        '&after=-60&points=1&format=json')
                if d['data'] and d['data'][0][1] is not None:
                    ups.append(d['data'][0][1])
            except Exception:
                pass
    return min(ups) if ups else None
В строке это «↻ 4d». Компромисс очевиден: деплой и падение с автоперезапуском выглядят одинаково. Но после деплоя я на страницу обычно и смотрю, так что мне этого хватает.
Публичное и приватное: два JSON вместо прокси к API
Самый простой способ сделать публичную страницу — отдать ей API парента через nginx. Я его отбросил почти сразу. Через /api/v1/data можно прочитать любой чарт любой ноды. В info алертов подставляются метки вроде ${label:url} — то есть внутренние адреса проб. Фильтровать это на уровне nginx — заведомо дырявое занятие.
Поэтому между API и браузером стоит снимок. status-snapshot раз в минуту собирает всё в один словарь и пишет два файла: полный — для приватной страницы, урезанный — для публичной:
def public(snap):
    """Наружу — только имена, статусы, история и рестарты: без нод, алертов и ссылок.
    Подписи проб в истории — короткие (public_label)."""
    # hist(): подписи проб укорачиваются до «health check», «TLS cert», «network link» —
    # без нод и префиксов проекта (public_label); совпавшие склеиваются в одну

    def strip(p):
        hot = any(RANK[a['status']] >= 2 for a in p['alarms'])
        dot = 'outage' if p['outage'] else CLS[p['worst']] if hot else 'nodata' if all(RANK[a['status']] == 1 for a in p['alarms']) else 'ok'
        return dict(name=p['name'], kind=p['kind'], dot=dot, restart=p['restart'],
                    history={rng: hist(h, p['name']) for rng, h in p['history'].items()})
    return dict(generated_at=snap['generated_at'], public=True, summary=snap['summary'],
                projects=[strip(p) for p in snap['projects']])
outage — состояние, которое добавилось позже. У каждого проекта есть обязательные алерты: по умолчанию pm2_app_down, mysql_down, clickhouse_down, *_health_down и *_healthcheck, у части проектов — свой список в конфиге. Если хоть один из них в CRITICAL, проект лежит целиком, и вместо красной точки страница показывает DOWN. Два prod-проекта в таком состоянии одновременно — заголовок «Major outage».
В публичном JSON нет ни имён нод, ни текстов алертов, ни ссылок — только имя проекта, тип, цвет точки, pm2-аптайм, две полоски истории, плюс общая сводка и время снимка. Записывается он атомарно, через временный файл и os.replace, чтобы страница не прочитала полфайла.
Таймер и юнит — обычные systemd, с песочницей, насколько это возможно для oneshot-скрипта:
# status-snapshot.timer
[Timer]
OnCalendar=minutely
AccuracySec=5s

# status-snapshot.service
[Service]
Type=oneshot
ExecStart=/usr/local/sbin/status-snapshot /etc/status-snapshot.json
Nice=10
ProtectSystem=strict
ReadWritePaths=/var/www/stats /var/www/status-public
PrivateTmp=true
NoNewPrivileges=true
В nginx два location. Приватный — за auth_request, публичный — просто alias на файл с запретом кеширования:
# stats.gistrec.cloud — приватная
location = /status.json {
    auth_request /_auth/check;
    error_page 401 = @fleet_login;
    expires epoch;
    alias /var/www/stats/status.json;
}

# gistrec.cloud — публичная
location = /status.json {
    expires epoch;
    alias /var/www/status-public/status.json;
}
Сама публичная страница живёт в репозитории сайта, роль Netdata о ней не знает — она отдаёт только JSON. Тот же JSON читает и главная страница сайта: кнопка «All systems operational» в шапке — это тот же снимок.
Обе страницы перечитывают status.json раз в 30 секунд и показывают возраст снимка. Если он старше трёх минут — таймер или парент встали — счётчик краснеет. На приватной странице цвет вердикта дублируется в favicon, чтобы состояние было видно на фоновой вкладке.
На приватной странице шрифты встроены в HTML как base64. Google Fonts из России открывается через раз, а страница состояния, которая висит на загрузке шрифта, — плохая страница состояния.
Грабли
Коллекторы баз сдались до того, как появились пользователи
Коллекторы mysql и clickhouse после первого деплоя на свежий хост не поднимались. Причина — порядок ролей в плейбуке. Роль netdata стоит в базовом плее для всех хостов, роли mysql и clickhouse — в отдельном плее позже:
111:- name: Baseline for every host (monitoring)
169:    - role: netdata
204:- name: Database servers — self-hosted MySQL + ClickHouse (Docker)
215:    - role: mysql
221:    - role: clickhouse
Коллектор go.d стартует, пробует подключиться пользователем netdata, которого ещё нет, не проходит автодетект и больше не пытается: autodetection_retry по умолчанию — 0. Лечение — одна строка в шаблоне джобы:
jobs:
{% for job in netdata_mysql_jobs %}
  - name: {{ job.name }}
    dsn: '{{ job.dsn }}'
    # DB user is created later in the play (db roles run after netdata)
    autodetection_retry: 60
{% endfor %}
Та же история с x509check: сертификаты выпускает роль tls в более позднем плее, так что на свежем хосте файла ещё нет. Там тоже autodetection_retry: 60.
Алерты появляются не сразу после рестарта
Health в Netdata инстанцирует алерты примерно через минуту после (ре)старта агента. Снимок, снятый в эту минуту, увидит меньше алертов, чем есть, — и это не ошибка скрипта. После деплоя роли, который перезапускает агента, страница на минуту худеет, и я к этому привык.
Ноды-призраки
Алерты удалённой ноды не исчезают с парента сами — они остаются с застывшим last_updated. Пока я не добавил отсечку по возрасту, на странице висела строка хоста, которого уже нет.
Ссылки из Telegram вели в никуда
Это не про страницу, но из той же серии «без Cloud». Ссылки в алертах Netdata строятся через registry: registry-alert-redirect.html должен найти агента по machine-guid. На 2.11 встроенный дашборд никогда не вызывает action=access, без которого резолвер не работает, — ссылка всегда упиралась в «Can't find any Netdata Agent». Я заменил резолвер на location = /registry-alert-redirect.html в nginx, который делает 302 на страницу алерта за /host/<имя>/ на паренте. Та же идея, что и со статусом: Netdata хранит данные, а показывать их удобнее своими средствами.
Что получилось
На скриншотах (27 октября 2026) публичная страница показывает 26 сервисов: 9 инфраструктурных, 8 продуктовых, 9 пет-проектов. В них учтено 170 алертов, ни один не горит, вердикт — «All systems operational». Размер публичного JSON — около 57 КБ.
Самая показательная строка — «Network». 23 октября у неё было 99.92% за сутки и 99.77% за неделю. Это ping-пробы между нодами, в том числе линк Россия↔Европа, который у меня моргает регулярно и про который алерты link_* пишут в Telegram. Теперь это видно и в истории, а не только в ленте уведомлений.
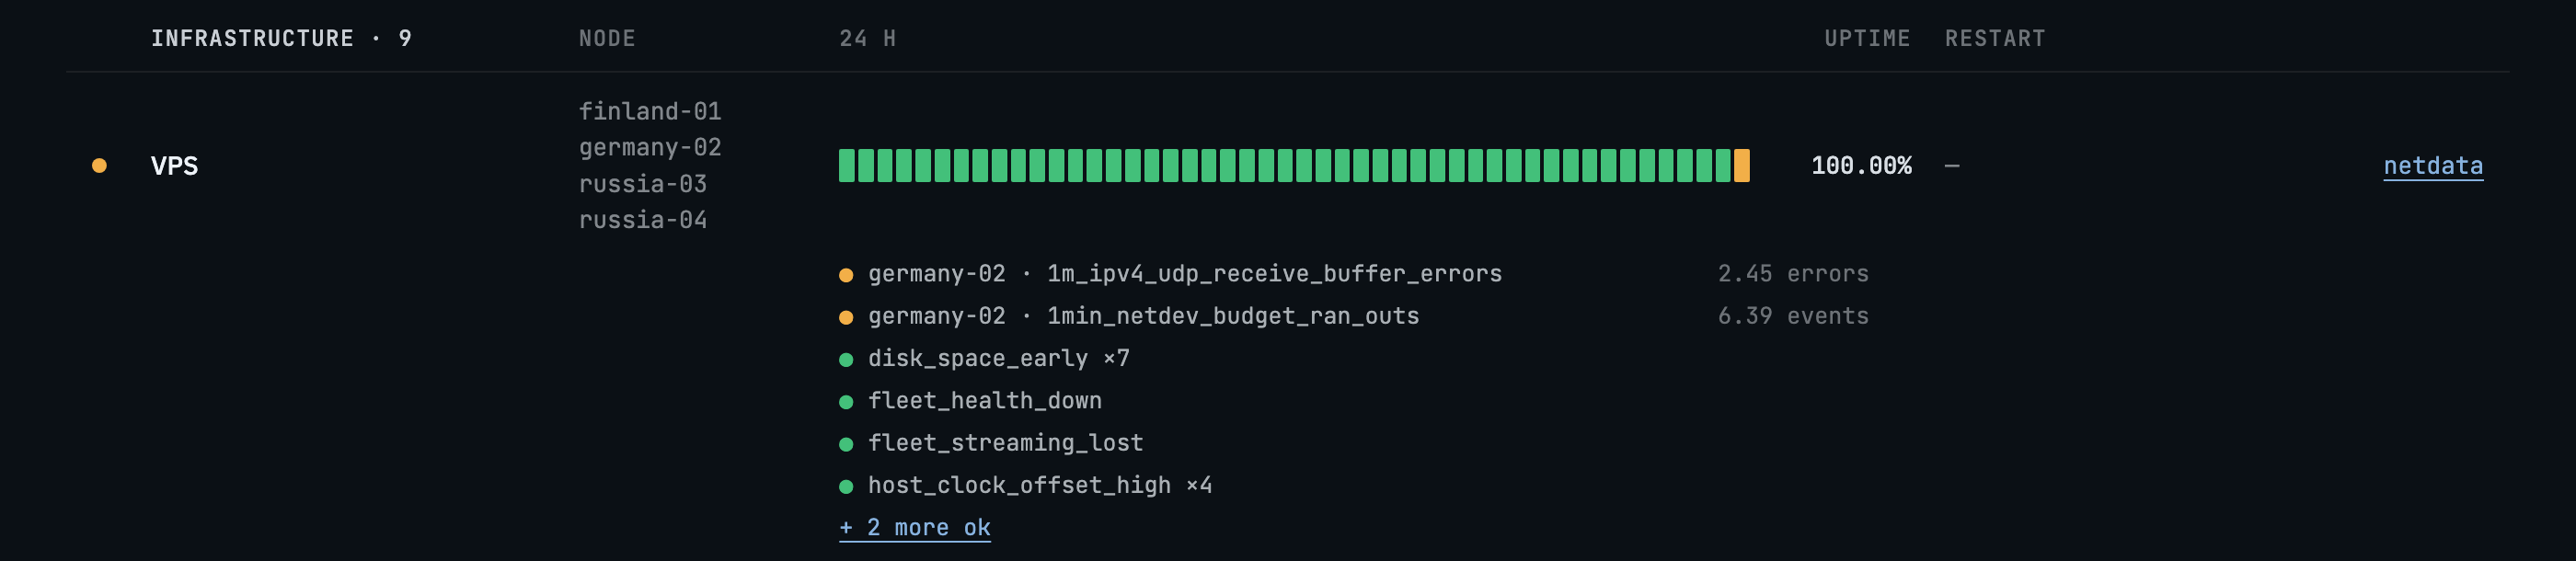
disk_space_early ×7).Один прогон снимка на паренте занимает около полусекунды и делает 172 запроса к API: 1 к info, 4 к alarms (по одному на ноду) и 167 к data (замер 28 октября).
Что бы я сделал иначе
Страница и парент живут на одной виртуалке. Если она умрёт, алерт об этом придёт с другой ноды (там стоит обратная проба fleet-watch), а публичная страница просто застынет с красным «updated 10m ago». Для честной статус-страницы публичный JSON стоило бы класть во внешнее хранилище или на второй хост. Пока не сделал.
«Проект = имя файла в health.d» — удобная конвенция, но она несущая: переименовал файл — на странице появилась новая строка, а старая исчезла вместе с историей. Код об этом не предупредит.
Полный пересчёт раз в минуту — простое решение, и на 26 сервисах оно не болит: 172 запроса и полсекунды. Каждый прогон — это alarms?all на каждую ноду, по два запроса к /api/v1/data на каждую пробу (24h и 7d) и ещё по одному на pm2-группу. Считать историю инкрементально я не стал, потому что не было повода.
Netdata собрала все данные для статус-страницы задолго до того, как я её захотел. Не хватало 372 строк, чтобы их показать.